本产品及文档完善中,如果有什么问题请联系我们:18721583683(同微信)或chaho@qq.com
Prometheus
XAgent 代理进程基于 Go 语言实现,内置 Prometheus 指标暴露能力。部署后访问 http://<主机IP>:<端口>/metrics 即可获取代理进程的标准运行指标,配合 Prometheus 采集与 Grafana 可视化,可对代理进程的运行状态、资源占用与健康度进行持续监控。
指标获取
XAgent 代理进程启动后,通过 HTTP 接口对外暴露 Prometheus 文本格式指标:
GET http://<主机IP>:<端口>/metrics
返回内容为 Prometheus 标准文本格式,包含 # HELP(指标说明)与 # TYPE(指标类型)注释行,可直接被 Prometheus Server 抓取,也可用 curl 手动验证:
curl http://<主机IP>:<端口>/metrics
以下为实际抓取的部分指标文本:
# HELP go_goroutines Number of goroutines that currently exist.
# TYPE go_goroutines gauge
go_goroutines 119
# HELP go_info Information about the Go environment.
# TYPE go_info gauge
go_info{version="go1.27.0"} 1
# HELP go_memstats_alloc_bytes Number of bytes allocated and still in use.
# TYPE go_memstats_alloc_bytes gauge
go_memstats_alloc_bytes 1.13662008e+08
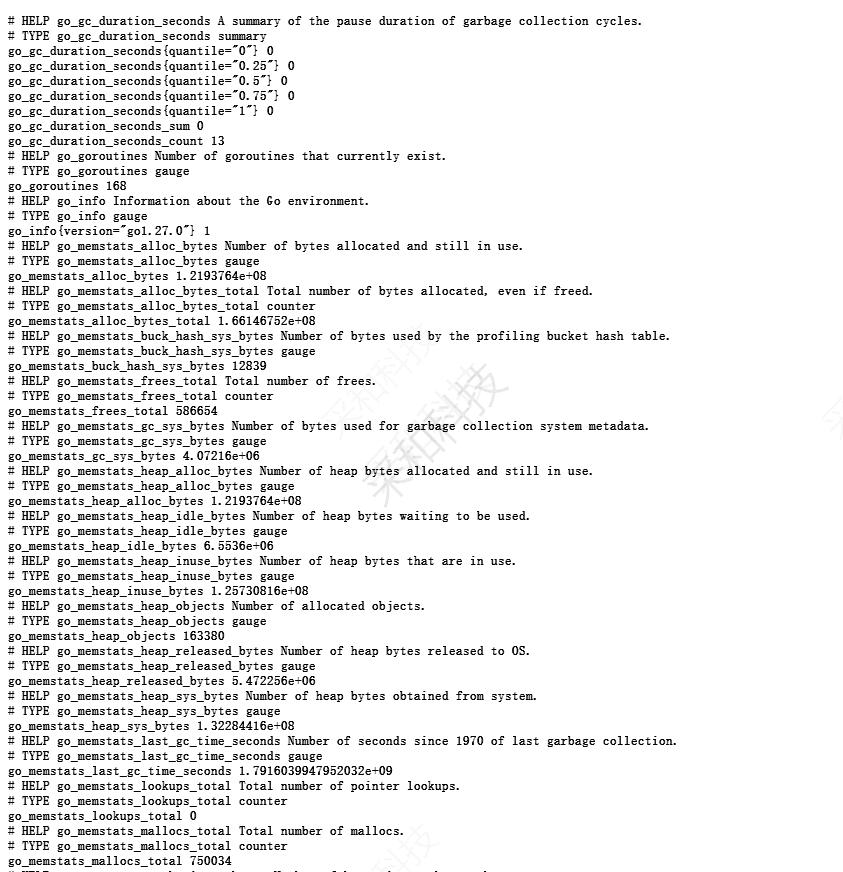
指标总览
XAgent 暴露的指标分为 Go 运行时指标 与 进程资源指标 两大类,全部遵循 Prometheus 命名规范(go_* 前缀为 Go 运行时,process_* 前缀为进程资源)。
Go 运行时指标
| 序号 | 指标 | 类型 | 说明 | 参考基线 |
|---|---|---|---|---|
| 1 | go_gc_duration_seconds | summary | 垃圾回收(GC)暂停耗时分布,按分位数(quantile 0/0.25/0.5/0.75/1)统计 | 单次 < 10ms,均值越低越好 |
| 2 | go_gc_duration_seconds_sum | counter | GC 暂停累计耗时 | 持续增长属正常,需关注增速 |
| 3 | go_gc_duration_seconds_count | counter | GC 执行次数 | 高频 GC 需关注内存压力 |
| 4 | go_goroutines | gauge | 当前存在的 goroutine(协程)数量 | 数百以内正常,异常增长多为泄漏 |
| 5 | go_threads | gauge | 当前操作系统线程数 | 与 CPU 核数相当,异常增长需排查 |
| 6 | go_info | gauge | Go 运行环境信息,含版本号(如 go1.27.0) | 版本越高越好 |
| 7 | go_memstats_alloc_bytes | gauge | 已分配且仍在使用的字节数(堆内存) | 关注趋势,持续攀升需排查 |
| 8 | go_memstats_alloc_bytes_total | counter | 累计分配的字节总数(含已释放) | 反映分配压力 |
| 9 | go_memstats_heap_alloc_bytes | gauge | 堆上已分配且在用的字节数 | 同 alloc_bytes |
| 10 | go_memstats_heap_inuse_bytes | gauge | 堆中正在使用的字节数 | 同 heap_alloc |
| 11 | go_memstats_heap_idle_bytes | gauge | 堆中空闲等待使用的字节数 | 内存回收是否充分 |
| 12 | go_memstats_heap_objects | gauge | 已分配对象数量 | 对象数异常增长需排查 |
| 13 | go_memstats_heap_sys_bytes | gauge | 堆从系统获取的内存总量 | 接近物理内存上限需扩容 |
| 14 | go_memstats_heap_released_bytes | gauge | 已归还操作系统的堆内存 | 越大说明回收越充分 |
| 15 | go_memstats_next_gc_bytes | gauge | 下次触发 GC 的堆阈值 | 达到即触发 GC,是内存水位标尺 |
| 16 | go_memstats_sys_bytes | gauge | 从系统获取的内存总字节数 | 进程整体内存占用 |
| 17 | go_memstats_mallocs_total | counter | 累计分配(malloc)次数 | 分配频繁需关注对象生命周期 |
| 18 | go_memstats_frees_total | counter | 累计释放(free)次数 | malloc/frees 差值≈存活对象 |
| 19 | go_memstats_last_gc_time_seconds | gauge | 最近一次 GC 的 Unix 时间戳 | 距当前越久说明内存越稳定 |
| 20 | go_memstats_stack_inuse_bytes | gauge | 栈分配器正在使用的字节数 | goroutine 栈占用 |
| 21 | go_memstats_mcache_inuse_bytes | gauge | mcache 结构正在使用的字节数 | 运行内部结构,观察即可 |
| 22 | go_memstats_mspan_inuse_bytes | gauge | mspan 结构正在使用的字节数 | 运行内部结构,观察即可 |
| 23 | go_memstats_gc_sys_bytes | gauge | GC 系统元数据占用字节数 | 运行内部结构,观察即可 |
| 24 | go_memstats_other_sys_bytes | gauge | 其他系统分配字节数 | 运行内部结构,观察即可 |
| 25 | go_memstats_buck_hash_sys_bytes | gauge | 性能分析桶哈希表占用字节数 | 运行内部结构,观察即可 |
| 26 | go_memstats_lookups_total | counter | 指针查找次数 | 现代 Go 通常为 0 |
进程资源指标
| 序号 | 指标 | 类型 | 说明 | 参考基线 |
|---|---|---|---|---|
| 1 | process_cpu_seconds_total | counter | 进程累计消耗的 CPU 时间(用户态+系统态,秒) | 与运行时长比值反映 CPU 利用率 |
| 2 | process_resident_memory_bytes | gauge | 进程常驻内存(RSS),即实际占用的物理内存 | 重点监控项,异常增长需排查 |
| 3 | process_virtual_memory_bytes | gauge | 进程虚拟内存大小 | 含映射文件,一般大于 RSS |
| 4 | process_open_fds | gauge | 当前打开的文件描述符数量 | 接近 max_fds 需排查泄漏 |
| 5 | process_max_fds | gauge | 进程可打开的文件描述符上限 | Linux 默认 ulimit 限制 |
| 6 | process_start_time_seconds | gauge | 进程启动时间(Unix 时间戳) | 用于计算运行时长与检测重启 |
| 7 | promhttp_metric_handler_requests_in_flight | gauge | 当前正在处理的指标抓取请求数 | 一般 ≤ 1 |
| 8 | promhttp_metric_handler_requests_total | counter | 指标抓取请求总数(按 HTTP 状态码区分) | 关注 200 比例,500/503 需排查 |
实测样例解读
以下为 XAgent 一次实际抓取的指标快照(实测环境),可直观了解各指标的典型取值与含义:
| 序号 | 指标 | 实测值 | 解读 |
|---|---|---|---|
| 1 | go_goroutines | 119 | 协程数量处于低位,说明服务负载很轻 |
| 2 | go_gc_duration_seconds_count | 12 | 进程累计 GC 12 次,频率很低 |
| 3 | go_info{version="go1.27.0"} | 1 | 代理基于 Go 1.27 构建 |
| 4 | go_memstats_alloc_bytes | ≈ 113.7 MB | 当前堆内存占用约 114 MB |
| 5 | go_memstats_alloc_bytes_total | ≈ 150.7 MB | 累计分配约 151 MB,分配压力低 |
| 6 | go_memstats_heap_inuse_bytes | ≈ 116.8 MB | 堆在用内存约 117 MB,与分配基本一致 |
| 7 | go_memstats_heap_objects | 55178 | 堆对象约 5.5 万个,规模正常 |
| 8 | go_memstats_mallocs_total | 521603 | 累计分配 52 万余次 |
| 9 | go_memstats_frees_total | 466425 | 累计释放 46 万余次,存活对象约 5.5 万(与 heap_objects 吻合) |
| 10 | go_memstats_last_gc_time_seconds | 1.7916e+09 | 最近一次 GC 时间戳,距抓取时点较近属正常 |
| 11 | go_memstats_lookups_total | 0 | 指针查找 0 次,符合现代 Go 预期 |
| 12 | promhttp_metric_handler_requests_total{code="200"} | 1 | 指标抓取请求成功返回 |
结论:该实例代理运行轻量、内存占用约 114 MB、GC 频率极低、协程数量平稳,适合大规模终端部署场景。
接入 Prometheus
在 Prometheus 配置文件 prometheus.yml 的 scrape_configs 中添加采集目标:
scrape_configs:
  - job_name: 'xagent'
    static_configs:
      - targets: ['<xagent服务端IP>:<端口>']
    metrics_path: /metrics
    scrape_interval: 15s
常用监控告警规则
在 Prometheus 告警规则中可配置以下常用告警项:
| 序号 | 告警名称 | 表达式 | 说明 |
|---|---|---|---|
| 1 | 进程挂掉 | up{job="xagent"} == 0 | 服务不可用 |
| 2 | 内存异常增长 | process_resident_memory_bytes{job="xagent"} > 1e9 | 常驻内存超 1 GB |
| 3 | 协程数异常 | go_goroutines{job="xagent"} > 1000 | goroutine 疑似泄漏 |
| 4 | GC 频繁 | rate(go_gc_duration_seconds_count{job="xagent"}[5m]) > 10 | 5 分钟内 GC 超 10 次 |
| 5 | 句柄耗尽风险 | process_open_fds{job="xagent"} / process_max_fds{job="xagent"} > 0.8 | 打开句柄超上限 80% |
Grafana 可视化
采集接入后,可在 Grafana 中新建 Dashboard,推荐面板:
| 序号 | 面板 | 数据源查询(PromQL) |
|---|---|---|
| 1 | 内存占用 | process_resident_memory_bytes{job="xagent"} |
| 2 | 堆内存趋势 | go_memstats_heap_alloc_bytes{job="xagent"} |
| 3 | 协程数量 | go_goroutines{job="xagent"} |
| 4 | GC 暂停耗时 | go_gc_duration_seconds{job="xagent"} |
| 5 | CPU 利用率 | rate(process_cpu_seconds_total{job="xagent"}[5m]) |
| 6 | 服务存活 | up{job="xagent"} |
运维建议
| 序号 | 建议 | 说明 |
|---|---|---|
| 1 | 定期观察 process_resident_memory_bytes 与 go_memstats_heap_alloc_bytes 趋势 | 内存持续攀升不下探,提示可能存在资源未释放 |
| 2 | 关注 go_goroutines 与 go_threads 的异常增长 | 二者持续增长是协程/线程泄漏的典型信号 |
| 3 | 关注 process_open_fds 逼近上限 | 句柄泄漏会导致服务无法建立新连接 |
| 4 | 配置进程存活与内存告警 | 优先保障"进程在线"与"内存水位"两项基础告警 |
| 5 | 结合 process_start_time_seconds 监控意外重启 | 非计划内重启说明服务异常退出,需回溯日志 |